NVIDIAが日本のAI開発向け合成データセット2種を発表 金融ペルソナは900万件、個人情報の検出用は10万件規模 実在の個人情報は不使用
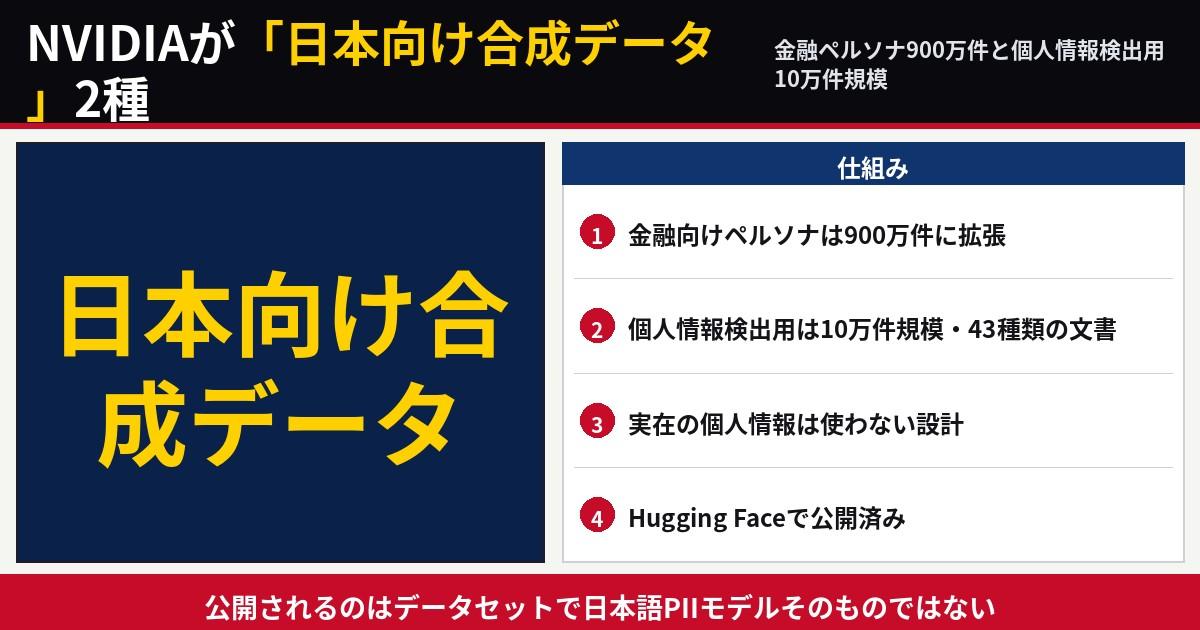
NVIDIAは10日、日本語AIの開発を支援する合成データセット2種を発表した。日本社会を反映した金融向けペルソナは900万件に拡張し、個人情報(PII)の検出・マスキング用データセットは10万件規模で43種類の文書を収録する。いずれも実在する個人情報を使わない設計で、Hugging Faceで公開された。
金融向けペルソナは600万件から900万件へ
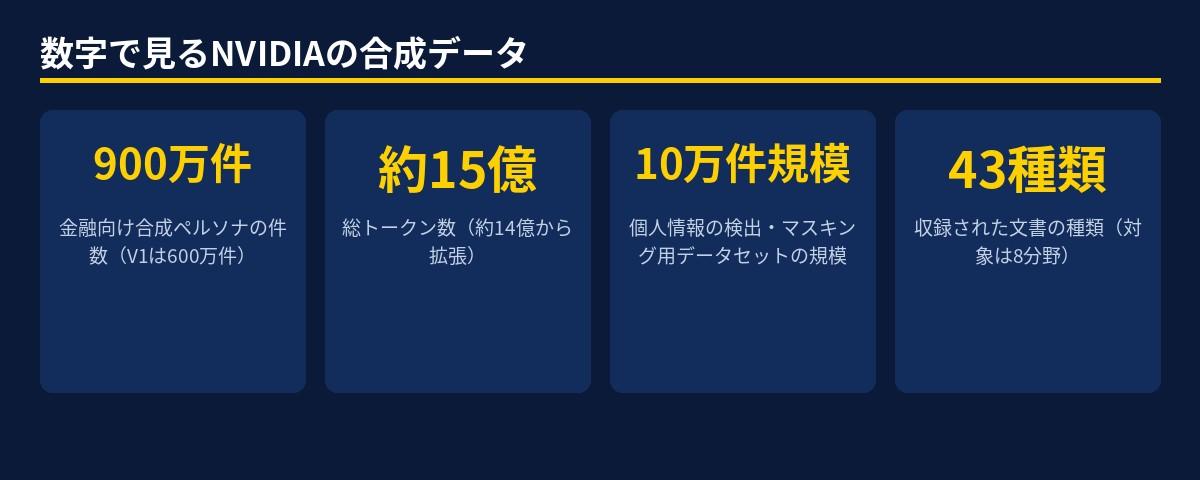
NVIDIA公式ブログによると、同社は都内で主催した開発者向けイベント「NVIDIA Agentic AI Day」で、「Nemotron Personas Finance Japan」と「Nemotron PII Japan」を発表した。金融向けペルソナは、2025年公開の「Nemotron Personas Japan」の基本属性を引き継ぎ、収入や資産、支出、貯蓄、投資などの属性を追加した。データセットは100万サンプルを基盤とし、ペルソナ数をV1の600万件から900万件へ、総トークン数を約14億から約15億へ拡張している。実装とデータ生成は東京大学・松尾研究所発のスタートアップElithが担当し、主要な金融機関が知見の提供で協力した。各社固有の顧客データや機密情報は使用していないという。
個人情報の検出用は10万件規模、8分野・43種類の文書
もう1つの「Nemotron PII Japan」は、PIIを含む日本語文書を想定して生成した10万件規模の完全合成データセットだ。医療、金融、行政、雇用、教育、法律、IT/セキュリティ、Eコマースの8分野を対象に、診断書やローン審査書類、住所変更届など43種類の文書を収録する。各文書には、氏名や住所などのPIIが文中のどこにあるかを示す注釈が付いている。アーリーアクセスにはNECが参加した。NVIDIAは、公開するのはデータセットであり日本語PIIモデルそのものではないとしている。
出典:NVIDIA Japan Blog「NVIDIA、日本のエージェント型AI開発を支える2つの合成データセットを発表」(2026年11月10日) https://blogs.nvidia.co.jp/blog/nvidia-agentic-ai-day-japan-2026-two-japanese-dataset/

▼ 確認できた事実
・NVIDIAが日本語AI向け合成データセット2種を11月10日に発表
・金融向けペルソナは900万件、総トークン数は約15億に拡張
・PII検出用は10万件規模、8分野・43種類の文書を収録
・実在の個人情報は使わず、Hugging Faceで公開済み